重读 DDD:从业务语言到一致性边界
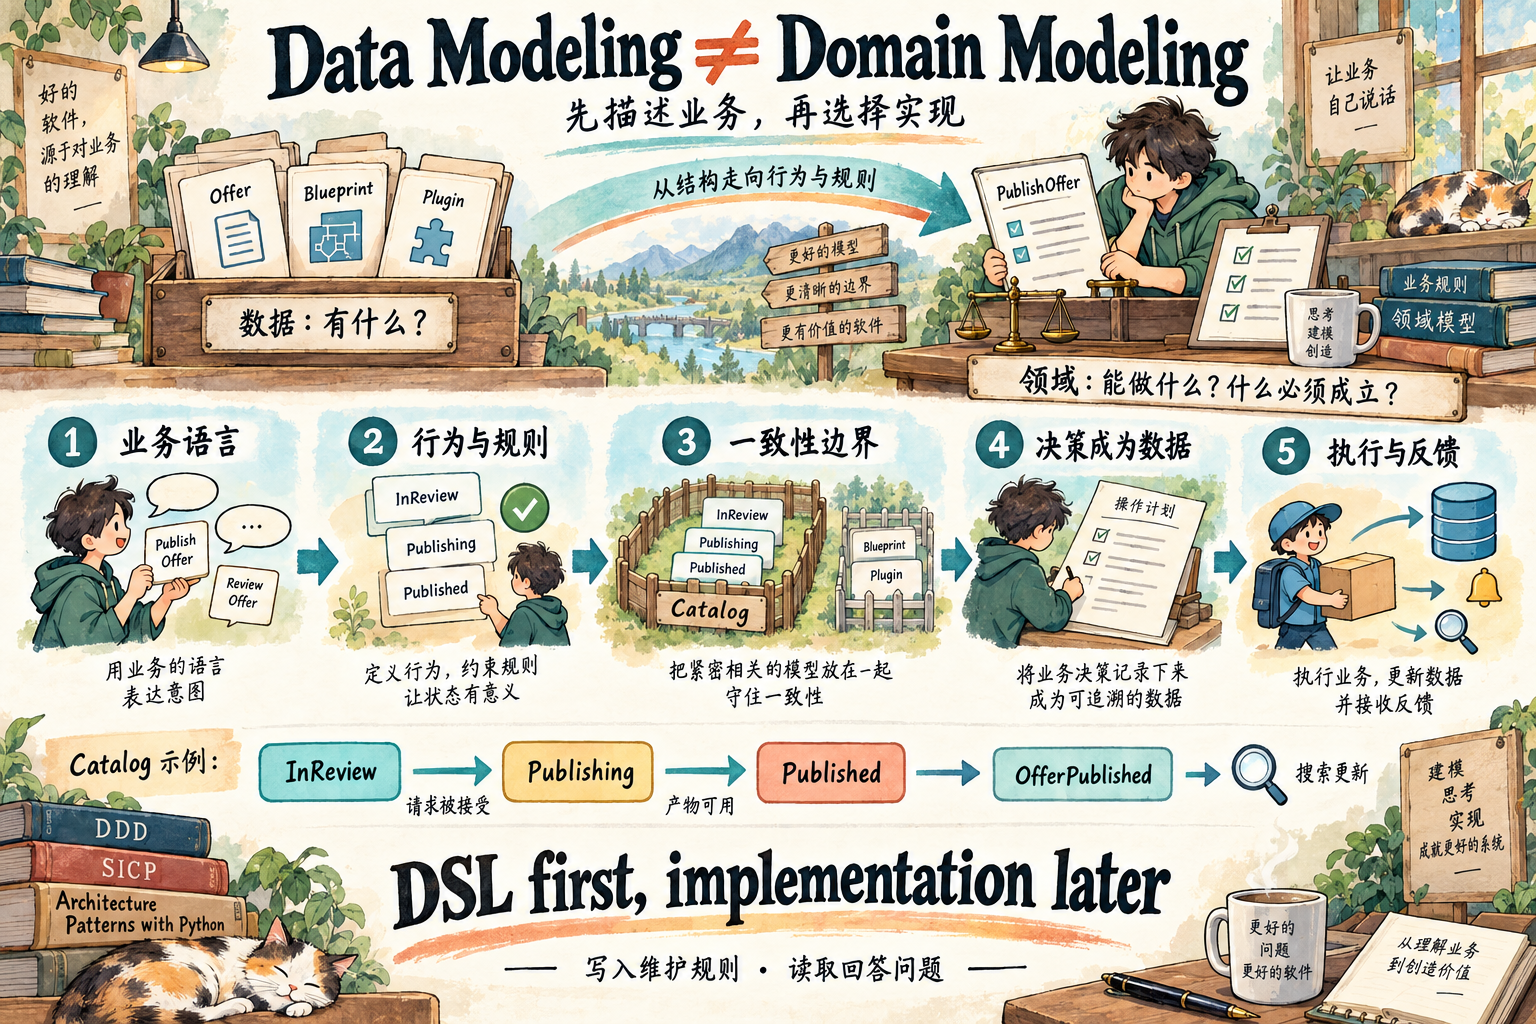
最近读 Architecture Patterns with Python,又重新想了一遍 DDD。
Entity、Value Object、Aggregate、Repository、Unit of Work,这些概念以前都接触过。但这次读下来,我开始意识到:过去一些自以为在做领域建模的工作,其实主要是在做数据建模。
这也和前段时间学习 SICP 有关。读 SICP 时,我越来越习惯先想,一个问题适合用什么计算模型表达,再去考虑代码如何组织。回到业务系统,同样的习惯变成了几个问题:业务在说什么?系统允许哪些行为?一次行为完成以后,什么必须仍然成立?
以前,我很容易从 Class、Table 和接口出发。现在,我更想先把业务语言和规则说清楚。这篇文章就用以前做过的一个 Catalog Service,记录这次变化。项目结构来自过去的经历;下面的发布规则和重设计方案,是为了讨论而做的简化与假设。
那个总是加载不完整的 Offer
Catalog Service 的业务结构,简化以后大概是这样:
Offer
 ├── Blueprint
 │    └── Plugin
 └── Document
一个 Offer 包含若干 Blueprint,Blueprint 又依赖 Plugin;Offer 还会关联一些 Document。它们有自己的 metadata、状态和生命周期。
数据库很自然地出现了 offers、blueprints、plugins、documents,以及关联它们的外键。顺着这套结构,内存里的对象也很容易长成同一棵树:
class Offer:
    blueprints: list[Blueprint]
    documents: list[Document]

class Blueprint:
    plugins: list[Plugin]
当时觉得,这已经很接近领域建模了:业务里有这些概念,代码里也有同名对象。
麻烦出现在不同的 Use Case 上。有的 API 只需要 Offer 的 metadata,有的需要 Blueprint 列表,有的要一路展开到 Plugin,还有的要返回完整详情。每次都加载整棵树很浪费,只加载一部分又会让对象处于不同的完整程度:
offer.blueprints = None # 没有 Blueprint,还是没有加载?
Repository 也开始出现越来越多的变体:
get_offer()
get_offer_with_blueprints()
get_offer_with_plugins()
get_full_offer()
当时我一直纠结的是,怎样设计一个更灵活、更通用的 Repository。现在回头看,更值得先问的是:为什么这么多用途,都必须经过同一个 Offer 对象?
1. Data Modeling ≠ Domain Modeling
这是这次重读 DDD,我最想先记住的一点:数据建模不等于领域建模。把业务名词变成表,再把表映射成 Class,并不意味着已经完成了领域建模。
过去我做数据建模时,更关注数据如何组织:有哪些字段,如何标识一条记录,数据之间有什么关系,需要哪些约束。而领域建模会让我继续追问:这些概念是什么意思,允许发生哪些行为,状态怎样变化,以及每次操作完成后,哪些规则必须仍然成立。
数据模型也能表达业务概念和约束,领域模型同样需要数据结构;问题在于,结构不能替代对行为和规则的建模。一张完整的 ER 图,仍然无法独自回答“这个 Offer 现在能不能发布”。即使对象上已经有了 status 字段,如果发布条件、状态转换和失败含义仍然散落在各个接口中,业务模型就没有得到清楚的表达。
“业务上包含”“数据库中关联”“修改时必须一起保持一致”,其实是三种关系。
用户认为 Blueprint 属于 Offer,说明它们在业务概念上有关联。数据库里的 offer_id 说明数据如何关联。这些信息都很有价值,但还不足以决定领域对象的边界。外键关系不能直接推导出聚合边界,页面需要的嵌套结构也不能直接决定领域模型。
我现在会先区分模型要回答的问题:
| 视角 | 要回答的问题 | Catalog 中的例子 |
|---|---|---|
| 业务概念 | 用户怎样理解这些东西? | Offer 由哪些内容组成 |
| 持久化模型 | 数据怎样保存与关联? | 表、外键、索引 |
| API 表示 | 调用方需要什么契约? | 详情字段、分页、兼容性 |
| 读取模型 | 怎样高效回答问题? | Offer 详情、待审核列表 |
| 领域模型中的写入部分 | 行为如何维护业务规则? | 提交审核、发布、撤回 |
这不意味着项目里必须复制出五套类。简单系统里,同一份结构可能已经足够。这里的区分,是为了在需求开始冲突时,知道该把哪些职责拆开。
对于 Catalog,我会先写出 SubmitOffer、PublishOffer、PublishBlueprint 这些行为,再追问它们的含义。例如,“发布”究竟是审核通过、产物已经可下载,还是已经能被搜索到?如果这几个时刻可能相隔几分钟,就不能靠一个模糊的 published 把差别藏起来。
业务语言也需要适用范围。Catalog 中的 Published,可能表示版本已经对外可用;部署系统中的 Running,则表示某个环境已经运行了这个版本。这是两个上下文中的概念,不必为了统一命名而合并成一个全局状态。DDD 的 Bounded Context 关注这种语言和模型的边界,后面要讨论的 Aggregate 则关注模型内部的数据变更边界,两者不能混为一谈。
所以,对 Catalog 做数据建模,我会讨论 Offer 与 Blueprint 如何关联;做领域建模,我还必须回答发布的含义、允许发布的条件,以及依赖发生变化时应该怎么办。后面关于聚合、读写模型和一致性的讨论,都是从这个区别继续展开的。
“部分加载的 Offer”也因此成了一个提示:也许懒加载没有问题,但我正在让同一个对象同时承担持久化、业务决策和页面展示。继续优化加载参数之前,应该先看看这些用途是否真的需要同一种模型。
2. Aggregate 的边界,要从规则里找
看到 Offer、Blueprint、Plugin 这棵树,很容易直接把 Offer 定成 Aggregate Root,把剩下的全部放进去。
但聚合要解决的是:哪些状态需要作为一个整体修改,才能在操作完成时维持业务约束?书中对 Aggregate 的讨论,正是沿着不变量、并发冲突和一致性边界展开的。Architecture Patterns with Python,第 7 章
假设 Offer 的状态是:
Draft ──Submit──> InReview ──Publish──> Published
“只有 InReview 才能执行 Publish”是一次状态转换的前置条件。它帮助我们维护合法的生命周期,但还没有解释 Blueprint 应该放在哪里。
如果 Blueprint 可以独立编辑、审核和发布,而且这些操作不要求同时修改 Offer,那么它很可能适合拥有自己的聚合。反过来,如果业务要求两者始终原子地变化,就必须认真考虑共同的边界或明确的协调机制。
独立生命周期是线索,外键也是线索;最后的判断仍然来自规则。我更愿意把“聚合尽量小”理解成:找到足以保护规则、又不会无谓扩大并发冲突范围的边界。 它不一定存在唯一、数学意义上的最小解。
发布需要 Blueprint,就必须加载整棵树吗?
假设增加一条规则:只有所有关联 Blueprint 都已发布,Offer 才能发布。
最直接的实现,是把所有 Blueprint 加载进 Offer,再逐个检查。但领域决策真正依赖的,可能只是“发布条件是否满足”,或者一份包含未就绪原因的检查结果。
应用层可以协调读取,领域对象接收决策所需的事实。下面只表示职责分工,并不是完整的并发安全实现:
with uow:
    offer = uow.offers.get(offer_id)
    readiness = uow.publish_requirements.for_offer(offer_id)

    offer.publish(readiness)

    uow.commit()
OfferRepository 加载要修改的聚合;PublishRequirements 提供发布判断需要的事实;Offer.publish() 解释这些事实并执行状态转换。发布要求简单时,事实可能只是一个布尔值;需要向用户解释失败时,则可以返回具体缺少哪些条件。
这解决了数据形状的问题:做决策需要足够的信息,不一定需要完整的对象图。
但还有一个更重要的问题没有解决:检查通过以后,这个事实会不会失效?
T1:检查 Blueprint,全部已发布
T2:撤回一个 Blueprint,提交
T1:发布 Offer,提交
即使这几行代码写在 with uow 里面,也不能仅凭语法认定它们是安全的。一个布尔值没有携带锁,也没有自动保护它所依赖的数据。
这时要回到业务,把“都已发布”说得更精确:
| 真实要求 | 需要考虑的设计 |
|---|---|
| 发布的是一组确定的、不可变的 Blueprint 版本 | 固定版本清单;后续编辑产生新版本,不改写这次发布的输入 |
| 发布判断与撤回操作必须有明确先后关系 | 让相关修改遵守共同的锁协议,或使用合适的隔离与重试机制 |
| Offer 发布以后,依赖必须持续可用 | 撤回、删除和修改关联的路径也必须维护规则;仅检查发布入口不够 |
采用不可变版本,也仍要明确这些版本能否被删除、禁用,以及发布中的依赖清单能否被替换。建模的价值就在这里:把隐藏在一句“检查通过”里的要求拆开,才能知道并发控制究竟要保护什么。
如果强一致的规则持续跨越两个聚合,而协调越来越复杂,也应该重新检查聚合划分。不能先决定拆小,再用一个查询接口假装边界之间没有依赖。
3. 写入和读取,可以各自拥有合适的模型
重新看开头那些 Repository 方法,我发现自己把两种读取混在了一起。
一种是为了修改:加载 Offer,检查规则,执行发布,保存结果。另一种是为了展示:返回 Offer、Blueprint、Plugin、Document 拼成的详情。
前者需要能够维护规则的领域模型;后者需要一个准确、方便消费的查询结果。详情 API 没有要执行的领域行为,就未必需要先还原整棵领域对象树,再把它序列化回 JSON。
PublishOffer                       GetOfferDetails
     │                                   │
Application Service                 Query Service
     │                                   │
Offer Aggregate                     SQL / View
     │                                   │
Repository + Unit of Work           OfferDetailsDTO
     │                                   │
     └──────── 同一个 PostgreSQL ─────────┘
这也是我这次重新理解 CQRS 的入口:让负责状态变更和负责查询的模型分开演进。书中先让读取路径绕过领域模型,直接通过查询返回数据;并不要求一开始就建设两套数据库。Architecture Patterns with Python,第 12 章
对于这个 Catalog,详情读取可以用 SQL、视图,或者几条有针对性的查询组装 DTO,按实际数据量和响应结构选择合适的方式。
这样,写入侧 Repository 主要服务于聚合的加载与保存,查询侧则可以提供 get_offer_summary()、get_offer_details()。这些不同的返回形状有了合理的位置,领域对象也不必用 None 表示“这部分今天没有加载”。
读取侧仍然需要权限过滤、租户隔离和明确的数据契约,只是不必为展示需求调用一遍写入行为。如果业务简单,共享模型更省事,也没有必要为了 CQRS 这个名字强行拆分。
4. SICP 带来的联系:让“要做的事”先成为数据
读到书中用文件同步解释抽象时,我很自然地想到了 SICP。
同步目录时,可以一边比较文件、一边执行 copy、move、delete;也可以先观察文件系统,计算出操作列表,再交给执行器。书中用这个例子讨论了怎样把决策与 I/O 分开。Architecture Patterns with Python,第 3 章
文件系统 ──观察──> 文件信息
                      │
                    比较规则
                      │
                      ▼
             Copy / Move / Delete
                      │
                    执行器
                      │
                      ▼
                   文件系统
一旦操作成为数据,我就能在真正执行以前查看它、测试它,或者做一次 dry run。测试不必真的复制一万个文件,只需要检查给定输入是否生成了正确的计划。
以前写这样的流程,我很容易顺着执行顺序想:先查什么,再改什么,最后调用哪个接口。现在我会多问一步:能不能先把“准备做什么”写成一份可以检查的结果? 就像同步目录时,先看到一张待执行的操作清单,再决定是否真的动手。
SICP 第四章讨论通过语言与求值器组织计算。我从中得到的启发是,可以先选择一种表达问题的语言,再为这种表达定义执行方式。把它联系到 DDD,是我自己的阅读联想:命令、状态和操作,也可以成为业务计算所使用的表达。SICP:Metalinguistic Abstraction
在 Catalog 中,这种思路可以落成一个很小的状态转换函数。下面省略类型定义:Status 表示状态,命令和事件都携带 offer_id,CannotPublish 表示业务拒绝。暂时假设产物已经就绪,发布只需要完成本地状态变更:
def decide_publish(
    status: Status,
    command: PublishOffer,
    ready: bool,
) -> tuple[Status, OfferPublished]:
    if status is not Status.IN_REVIEW:
        raise CannotPublish("Offer 不在审核状态")
    if not ready:
        raise CannotPublish("发布条件尚未满足")
    return Status.PUBLISHED, OfferPublished(command.offer_id)
它只表达一件事:给定状态、命令和事实,允许怎样的转换。数据库连接、SQL、通知客户端都没有进入这个函数。应用层负责为命令中的 Offer 加载状态和事实,再持久化决定。
给它审核中的状态和满足条件的输入,就能检查它是否返回 Published;换成不满足条件的输入,就能检查拒绝原因。这些规则可以在连接数据库以前被验证。领域对象修改自己的内存状态、记录事件,也可以保留这样的职责分离。
我以前在 Scala 函数式编程里关注过计算如何成为值。现在感觉这条线又接到了业务架构上:先让规则和意图拥有可以检查的表达,再把外部操作交给明确的执行边界。
Command 表达意图,Event 记录事实
PublishOffer 的意思是“请尝试发布”,它可以被拒绝;OfferPublished 的意思是“发布已经发生”。命令与事件在语义上的区别,也是书中消息处理设计的重要基础。Architecture Patterns with Python,第 10 章
不过,上面的函数返回事件时,数据库还没有提交。它仍然只是当前事务中产生的事件;只有状态成功提交,才可以把它当成可靠的、可对外传播的事实。事务回滚时,不能让外部订阅者收到一个并未真正完成的发布通知。
发布成功以后,搜索索引更新失败,应该描述为“索引尚未跟上发布结果”。这和“发布命令被拒绝”需要不同的处理:前者可能重试消费,后者需要调用方修正输入或等待条件满足。
消息总线则把这些反应连接起来。书中的进程内 Message Bus 可以从很简单的事件分发开始,并不等于必须先引入消息中间件。Architecture Patterns with Python,第 8 章
这样看消息处理,我更容易读懂它背后的因果关系:什么意图被接受了,什么事实因此发生,接下来谁需要作出反应。业务流程也就有了可以直接讨论的表达。
5. 先确定承诺,再选择事务、锁和消息
回到那个发布判断:即使领域代码已经写对,如何保证保存结果时,它依赖的事实仍然可靠?到这里,事务与并发控制才有了明确的任务。
书中的 Unit of Work 把提交与回滚封装到应用层可使用的接口中,使一次用例里的持久化操作能够明确地一起成功或失败。它本身不决定领域边界,也不凭空提供比底层事务更强的隔离保证。Architecture Patterns with Python,第 6 章
例如,决策基于 Offer 的版本 17,就可以在保存时检查版本是否仍然匹配;不匹配就回滚并重新判断,或报告冲突。这要求相关写入共同维护版本,而且它只保护 Offer,不能自动保护独立变化的 Blueprint。
快照、锁和事务隔离的区别,我在 重新理解 PostgreSQL 隔离级别里展开过。这里更想留下一个判断:如果“撤回 Blueprint”这个操作本身允许破坏已发布 Offer 的依赖关系,那么即使两个操作完全串行执行,也会得到错误的业务结果。
数据库能帮助落实规则,却不会替我补上漏写的规则。 选择并发机制以前,仍然需要把发布、撤回这些行为放在一起考虑。
事务之外,发布可能是一段流程
如果发布只修改 PostgreSQL,一次本地事务可能已经足够。但如果还需要上传 S3、发送 Kafka 消息、更新搜索索引,with uow 无法把这些系统全部包进同一个本地 ACID 事务。
这时,“发布完成”必须重新定义。假设产物上传是对外可用的必要条件,而搜索可以稍后更新,可以考虑这样的流程:
InReview
   │ PublishOffer:保存发布输入,记录上传请求
   ▼
Publishing
   │ 上传产物成功,确认对应版本
   ▼
Published
   │ OfferPublished
   ├──> 更新搜索索引
   └──> 发送通知
Publishing 表示系统已经接受发布请求,但还没有满足完成条件。上传失败时,可以停留在这里等待重试,也可以按业务规则进入失败状态;不能为了让接口看起来简单,提前写成 Published。
有了这套状态语义,再来选择可靠执行的机制:例如通过 Transactional Outbox,在同一个本地事务里保存状态和待发送消息,再由独立投递器发送。投递可能重复,需要消费者幂等处理;外部操作失败后,则需要重试、对账或有业务含义的补偿。
这些问题与我之前写的 异步任务调度:从数据到工作流是相通的:消息系统提供执行通道,业务状态机才说明当前进度、何时算完成,以及失败后允许怎样继续。
哪些变化必须立即一致,哪些结果允许稍后跟上,要从业务承诺中确定。在这个例子里,产物可用是发布完成的条件,搜索更新则可以延后。这个区别,单看 offers.status 这个字段是看不出来的。
以后面对项目:DSL first
以后面对项目,我会先和业务一起把语言说清楚,再用具体场景检验它。以本文讨论的发布流程为例,我希望在设计表结构以前,先能写出这样的描述:
审核中的 Offer 可以接受发布请求。
依赖未就绪时,拒绝请求,并说明原因。
请求被接受后,固定这次发布的版本清单,进入 Publishing。
对应产物可用后,进入 Published,产生 OfferPublished。
搜索索引随后更新;索引延迟不改变已经完成的发布事实。
这些句子已经能拿来讨论:接受请求和发布完成是两个时刻;发布针对确定的版本;搜索更新可以滞后。任何一条不符合真实业务,都应该先改这份描述,再改实现它的代码。
接着,用具体场景把语言落到行为、状态转换和规则上,再寻找需要一起保护的一致性边界。表结构、Class 和技术组件的选择,都围绕这些已经明确的要求展开:
业务语言与场景
      │
      ▼
行为、状态转换与规则
      │
      ▼
一致性要求与模型边界
      │
      ├── 写入:领域决策 → 并发控制 → 本地事务
      │
      ├── 读取:查询需求 → 数据组织 → 响应契约
      │
      └── 外部影响:操作 / 消息 → 执行 → 失败恢复
这也不会是一条只走一次的流水线。真正实现时,数据量、并发、失败方式可能暴露出原先模型的问题,需要回来修改边界。所谓先考虑业务,是先建立判断技术方案的依据。
我把这种习惯概括成 DSL first, implementation later。团队共同使用的业务语言,在 DDD 中对应 Ubiquitous Language;再把它落实为有明确语义、能够表达和组合业务行为的小语言,才进一步接近 DSL。它可以直接嵌在 Python 的命令、函数和规则组合中,不必另写 parser。领域名词给了我们词汇,行为与规则则决定这些词怎样组成有意义的表达。Ubiquitous Language、Domain Specific Language
SICP 让我更关注表达计算的语言,DDD 则让我更关注表达业务的语言。以后做设计,我会先尝试用这套语言描述系统:它接受什么意图,依据哪些事实做出决定,维护什么规则,最终产生哪些影响。当这些问题能够被清楚地表达,才有依据判断 Repository、Unit of Work、消息总线或者某种并发机制是否适合。
DSL first:先描述业务如何运转,再决定代码如何实现。