重新理解 PostgreSQL 隔离级别:从看见数据到做出决定
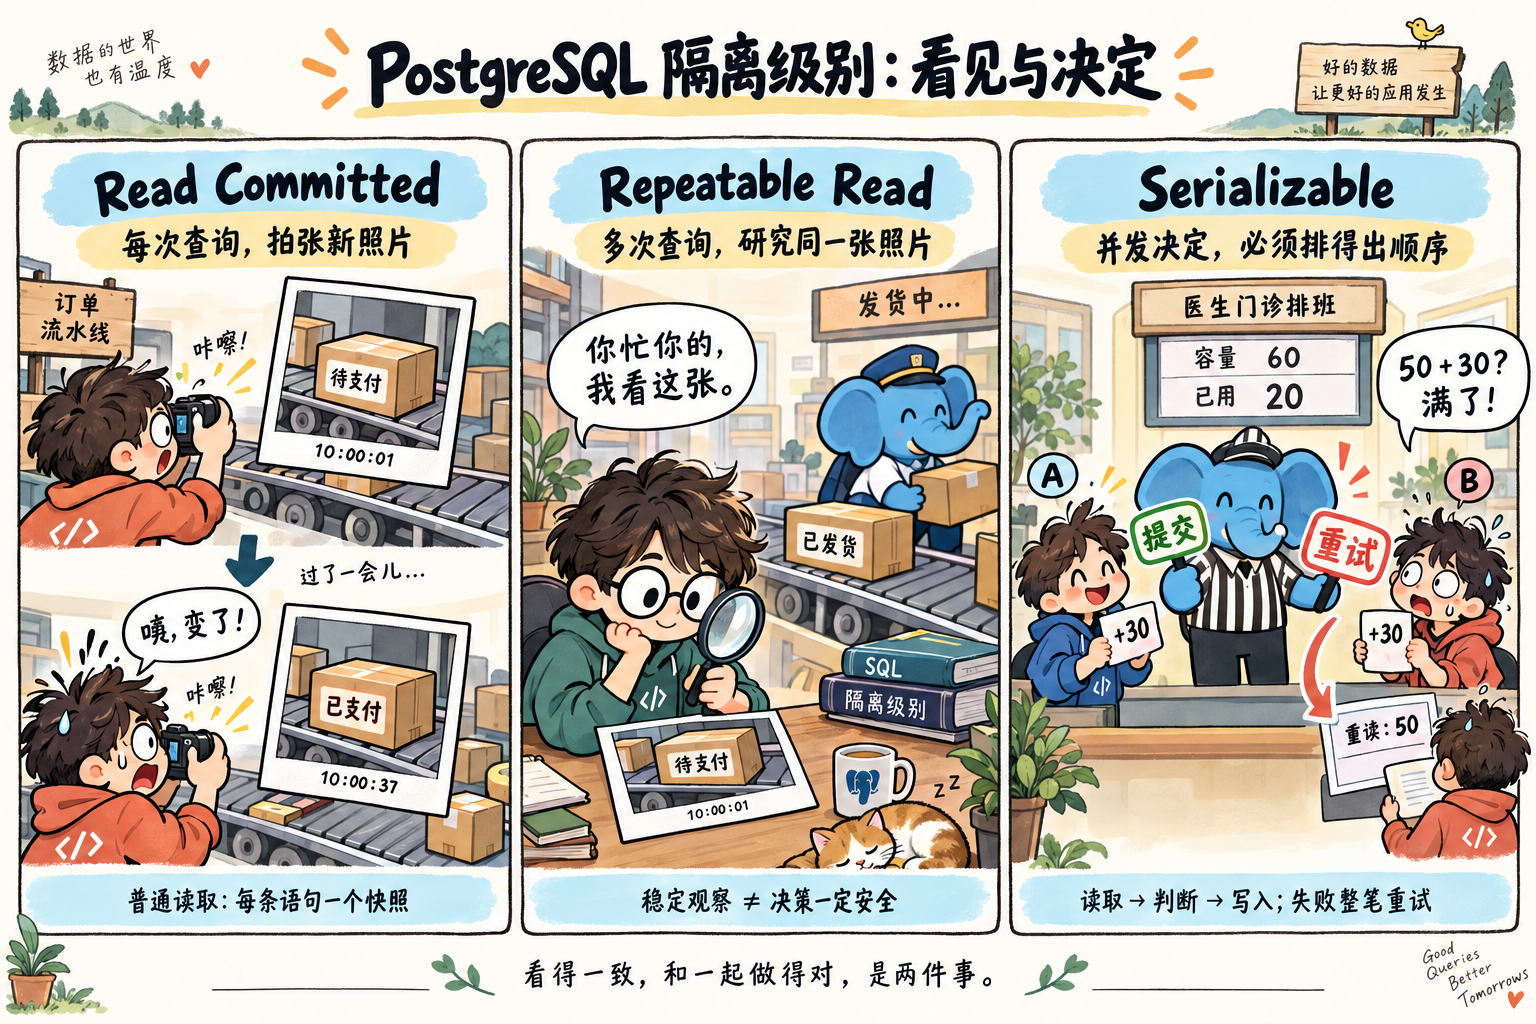
之前写过一次 PostgreSQL 的事务和隔离级别,回头看更像是在整理概念。真到写业务时,我还是会犹豫:已经有事务和行锁了,Repeatable Read 到底多保护了什么?
我觉得更好的入口,是先想一件很普通的事:读取数据本身也需要时间,而数据库在这段时间里一直在变化。
这会带来两个不同的问题:一次业务操作分多次读取,拿到的数据能不能放在一起理解?多个业务操作各自读完数据、做出决定,这些决定又能不能一起成立?
下面就从这两个问题往下走。本文讨论的是 PostgreSQL 的行为;其他数据库里同名的隔离级别,细节可能不同。
读完一个订单,究竟读到了哪个时刻?
假设订单详情分散在几张表中,应用会执行三条查询:
SELECT status FROM orders WHERE id = 123;
SELECT status FROM payments WHERE order_id = 123;
SELECT status FROM shipments WHERE order_id = 123;
为了把问题说清楚,先约定写入端的行为:支付事务会一起更新订单和支付记录;发货事务会一起更新订单和物流记录。因此,数据库已经提交的状态依次是:
| 时刻 | 订单 | 支付 | 物流 |
|---|---|---|---|
| t0 | 待支付 | 待支付 | 无记录 |
| t1:支付事务提交后 | 已支付 | 已支付 | 无记录 |
| t2:发货事务提交后 | 已发货 | 已支付 | 已发货 |
写入端每次都把相关修改放在同一个事务里,没有留下半成品。但读取端仍然可能这样执行:
读取端                            写入端

查 orders → 待支付
                                  支付事务提交
查 payments → 已支付
                                  发货事务提交
查 shipments → 已发货
最后页面上拼出来的是:订单待支付,支付已完成,物流已发货。
每次查询都读到了真实提交过的值,可这个组合没有在上面的任何一个已提交状态中出现过。写入的原子性保证了一次提交完整发生,却没有保证读取端的多条查询都站在同一个观察位置。
如果用户只是看一个不断刷新的列表,前后略有变化可能可以接受。但如果这是一次对账、报表导出,或者应用要把这些数据当作同一份订单状态来解释,就需要更明确的保证。
Read Committed:每次查询,重新看一次
PostgreSQL 默认的隔离级别是 READ COMMITTED。理解普通 SELECT 时,可以把它想成:查询开始时,拿到一张当时已提交数据的照片,然后基于这张照片完成读取。此外,它也能看到本事务此前尚未提交的修改。
PostgreSQL 的 READ UNCOMMITTED 实际也按 Read Committed 执行,所以本文集中讨论三种实际不同的行为。
即使查询执行了几秒钟,其他事务在这几秒里提交的修改,也不会突然混进这次普通查询的结果。但下一条查询会重新拍一张照片。
同一个事务

SELECT orders     → 快照 A
SELECT payments   → 快照 B
SELECT shipments  → 快照 C
所以,给刚才的三条查询包上 BEGIN 和 COMMIT,并不能自动解决问题。它们虽然属于同一个事务,普通读取使用的快照仍然可能不同。
这也解释了一个实用区别:如果订单详情能通过一条普通的联表查询拿到,那么在 Read Committed 下,这次查询本身就使用同一个语句快照。需要多条查询共享观察位置,才是接下来要解决的事情。
这里的“照片”描述的是普通读取。UPDATE 或 SELECT ... FOR UPDATE 遇到并发更新时,还涉及等待和更新后版本的处理,不能把所有 SQL 都理解为只处理照片上的旧值。后面的库存例子会用到这个区别。
Repeatable Read:用一段时间,看同一张照片
如果订单详情必须拆成多次查询,可以明确使用 Repeatable Read:
BEGIN TRANSACTION ISOLATION LEVEL REPEATABLE READ READ ONLY;

SELECT status FROM orders WHERE id = 123;
SELECT status FROM payments WHERE order_id = 123;
SELECT status FROM shipments WHERE order_id = 123;

COMMIT;
这时,其他事务仍然可以支付、发货、提交,读取端却会沿用同一个快照。如果快照建立在支付之前,那么它依次看到的就是:待支付的订单、待支付的支付记录、尚不存在的物流记录。
真实提交状态:待支付 ───── 已支付 ───── 已发货
                 │
                 └── 固定快照
                       ├── 第一次查订单
                       ├── 第二次查支付
                       └── 第三次查物流
三次读取发生在不同的物理时刻,却共享同一个逻辑观察位置。Repeatable Read 让我们有时间把一份数据读完,而不必边读边追赶别人的修改。
这就是它在多查询报表、数据导出、复杂详情组装中的价值。至于为什么查询到的状态不是最新的,那恰好是这个保证的代价:应用选择了前后一致的观察位置。
“同一张照片”还有两个边界需要记住:
- 快照并非执行
BEGIN的那一刻就固定,而是在第一条非事务控制语句开始时建立。在这个例子中,就是第一条SELECT。 - 如果事务允许写入,后面的查询能看到本事务前面已经做出的修改。固定的是对其他事务变化的可见范围,并不是让自己也永远看不到自己的写入。
这些具体语义可以对照 PostgreSQL 的事务隔离文档。
照片从哪里来?
PostgreSQL 通过 MVCC 保留和选择不同的数据版本。别人提交了新版本,不意味着当前事务必须立刻放弃自己还能看到的旧版本。
这里不需要先记住 tuple 上的字段,只要理解:数据库不必为了让你继续看旧数据,就拦住所有正在修改数据的人。普通读取通常可以和更新并行。
当然,旧版本也需要维护。长时间持有快照,会让某些旧版本暂时无法回收。因此,导出所需的稳定快照有用,但不应该把事务开着等用户操作,或者在事务里做大量与读取无关的工作。
到这里,我们解决了“读到的数据能否放在一起理解”。但如果读完以后还要据此做决定,问题会继续往前走。
两个各自合理的决定,为什么加起来错了?
考虑一个简化的医生预约系统。这里先不讨论具体起止时间是否重叠,只检查某个小时的总容量:一个医生在这个小时内,预约总时长不能超过 60 分钟。
已有预约用了 20 分钟,现在同时来了两个各需要 30 分钟的请求。
应用的逻辑很直接:
used = sum_duration(doctor_id, slot_start)

if used + requested_minutes > 60:
    raise ScheduleFull()

insert_appointment(doctor_id, slot_start, requested_minutes)
把整段逻辑放进 Repeatable Read 事务里,仍然可能发生:
| 执行顺序 | 事务 A | 事务 B |
|---|---|---|
| 1 | 查询总时长:20 | |
| 2 | 查询总时长:20 | |
| 3 | 判断 20 + 30 ≤ 60,可以预约 | |
| 4 | 判断 20 + 30 ≤ 60,可以预约 | |
| 5 | 插入一条 30 分钟预约 | |
| 6 | 插入另一条 30 分钟预约 | |
| 7 | 提交成功 | |
| 8 | 提交成功 |
最终总时长变成了 80 分钟。
两个事务没有更新同一行,它们插入的是各自的新预约,因此也没有因为争抢同一行而自动互斥。两边的判断各自成立,但都遗漏了对方即将占用的容量。
Repeatable Read 在这里依然完成了自己的工作:A 看不到 B 后来提交的新预约,B 也看不到 A 后来提交的新预约。可对于预约规则来说,这恰好意味着两边都在根据不包含对方的数据做决定。
稳定快照保证观察不会被别人中途改变,却不能保证基于这些观察做出的所有决定都能同时成立。 这类跨行读写导致的异常,通常被称为 write skew(写偏斜)。
这也说明为什么“没有幻读”还不够。PostgreSQL 的 Repeatable Read 不会让后一次普通查询突然多出别人新插入的预约,但它仍然允许上面两个事务都提交。记住查询结果是否变化,还不足以判断业务规则是否得到保护。
Serializable:把两个人的决定排个顺序试试
现在换一个判断方法:假设两个请求真的一个接一个执行,会发生什么?
如果 A 先执行,它读到 20,加入 30,提交后总时长是 50。接着 B 执行,就会读到 50,发现再加入 30 会超过 60,于是拒绝预约。
把顺序反过来,结论也一样:只能有一个请求成功。
因此,刚才“两边都读到 20,两边都提交成功”的执行过程,无法解释成任何一个串行顺序。
Serializable 所要求的,就是成功提交的事务,其读取结果和写入效果能够与某种串行执行顺序相容。它不是只检查最后的总数,也不要求现实中真的按那个顺序排队。
如果预约操作都使用 Serializable,并在事务内完成查询、判断和插入,那么在上面的交错执行中,PostgreSQL 就不能让两个事务都成功提交。它会让其中一个发生序列化失败,例如:
ERROR: could not serialize access due to read/write dependencies among transactions
SQLSTATE: 40001
错误可能出现在执行语句时,也可能在提交时出现。应用不能在 INSERT 返回后就宣告预约成功,要等事务提交完成。
数据库怎么知道“不能超过 60 分钟”?
它并不知道。
60 分钟是应用检查的规则。数据库关心的是:A 读取了一组预约,B 插入了会影响这组查询结果的数据;与此同时,B 的读取又会受到 A 插入的影响。
在这个例子中,可以把依赖理解为:
A 没看到 B 的预约 → 要解释 A 的读取,A 应该排在 B 前面
B 没看到 A 的预约 → 要解释 B 的读取,B 又应该排在 A 前面

两种要求无法同时满足。
PostgreSQL 使用 SSI(Serializable Snapshot Isolation),让事务基于快照并发执行,同时追踪读写依赖,在发现危险结构时中止某些事务。它也可能保守地中止事务,并不需要先重放出一次已经发生的错误预约。
应用负责保证“单独执行这段业务逻辑时,规则能被维护”;数据库负责约束并发执行的历史。两层组合起来,才得到想要的业务保证。
这个前提很重要。如果应用根本没有检查容量,串行插入也会超额,Serializable 自然不会替它补上检查。如果某条写入路径绕过了这套事务协议,也不能指望其他请求使用 Serializable 就把规则兜住。
同样,如果 used = 20 来自 Redis 缓存,而数据库事务里只有插入,数据库就没有观察到“这次写入依赖预约总时长”这件事。要靠 Serializable 保护这个判断,相关数据库读取必须发生在同一个事务里。
重试的是一次决定,不只是一次 INSERT
假设 A 成功提交,B 收到 40001。这时 B 应该回滚,重新开始事务,再执行完整流程:
第一次尝试
读到 20 → 判断可以预约 → 尝试写入 → 序列化失败

重新开始
读到 50 → 判断容量不足 → 拒绝预约
第二次尝试并不保证预约成功。它保证应用重新读取数据,再决定现在还能不能预约。
如果重试时沿用第一次的 used = 20,只把失败的 INSERT 再执行一遍,就跳过了需要重新验证的部分。PostgreSQL 的序列化失败处理文档明确要求重试整个事务,包括决定执行哪些 SQL、使用哪些值的应用逻辑。
重试要有次数上限和退避,也要避免把邮件、支付等不可随事务回滚的外部动作重复执行。Repeatable Read 的写事务同样可能因并发更新收到 40001,也需要从头重试。
行锁和版本号,在这个故事里分别做什么?
讲到这里,很容易接着问:那我直接加锁行不行?
可以,但要先找到真正需要共同竞争的资源。
锁已有预约,不等于锁住剩余容量
如果只是把当前查到的预约行 FOR UPDATE,锁住的是这些已有行。其他请求插入的新预约并不天然受这些行锁保护,查询没有返回任何行时更是无行可锁。
预约例子可以换一种建模方式:为每个医生的每个时段预先准备一条 doctor_slots 记录。所有会影响容量的操作,都先锁这条共同的时段记录。
BEGIN TRANSACTION ISOLATION LEVEL READ COMMITTED;

SELECT doctor_id, slot_start
FROM doctor_slots
WHERE doctor_id = 100
  AND slot_start = TIMESTAMP '2026-09-22 10:00:00'
FOR UPDATE;

-- 确认时段行存在并取得锁之后,再用下一条语句读取容量。
SELECT COALESCE(SUM(duration_minutes), 0)
FROM appointments
WHERE doctor_id = 100
  AND slot_start = TIMESTAMP '2026-09-22 10:00:00';

-- 应用判断;容量允许才 INSERT,否则 ROLLBACK。
-- 写入和判断必须使用当前事务的同一连接。

COMMIT;
这时第二个请求会先等待时段锁。等第一个请求提交,第二个请求取得锁后,再执行新的求和查询,就能在 Read Committed 下读到前一个请求提交的预约。
这里特意使用 Read Committed,并把求和放在取得锁之后的下一条语句中。若沿用一个更早建立的 Repeatable Read 快照,等待锁并不会自动刷新那张照片。
锁方案的正确性来自所有相关操作遵守同一个入口:锁定确实存在的共同资源,再读取、判断和修改。PostgreSQL 的行锁文档描述了这些冲突和等待行为。
Serializable 中也有叫 SIReadLock 的谓词锁,但它用于记录读取依赖,不会像这里的 FOR UPDATE 一样把竞争者挡在门外。两种机制的名字都有“锁”,作用却不能混用。
版本号保护的是约定好的修改边界
另一个常见办法是在订单上放一个版本号:
UPDATE orders
SET status = 'shipped',
    lock_version = lock_version + 1
WHERE id = 123
  AND lock_version = 17;
如果更新了零行,就说明这次更新的前提不成立:记录可能已经变了,也可能已经不存在。应用需要处理冲突,不能当作成功。
这个办法很适合“我根据版本 17 做了决定,保存时确认它还没有被别人改过”。但在预约例子里,A 和 B 插入的是两条不同记录,给各自的预约行加版本号,并不会让它们产生共同冲突。
也可以让所有影响容量的操作都校验同一条时段记录的版本:先读版本,再读取容量、做判断,把预约插入和 WHERE lock_version = 预期版本 的条件更新放在同一个事务里。如果版本校验失败,就回滚整次操作,重新读取和判断。仅仅无条件地把版本号加一,并不能阻止双方都预约成功。
这时真正起作用的是:业务规则有了一个共同的校验和写入位置。
回到业务里,怎样选择?
我现在会先写下想保护的具体规则,再看它依赖哪些数据。
如果规则是“库存不能扣成负数”,可以直接把条件和修改写在一起:
UPDATE inventory
SET available = available - 1
WHERE sku = 'ABC'
  AND available >= 1
RETURNING available;
在 Read Committed 下,如果两个请求争抢同一行,后来的更新会等待,并在对方提交后对新版本重新检查条件。因此只剩一件库存时,后一个请求不会继续按旧值扣减。应用检查是否返回行,再决定这次购买能否继续。
注意,关键是这条 SQL 把条件和修改放在了同一行上。把 SUM(...) 检查和插入拼进同一条复杂 SQL,并不因此自动解决前面的跨行预约问题。
如果规则是“同一个业务编号不能重复”,用唯一约束通常更直接。其他选择也可以回到各自要保护的前提:
| 实际需求 | 可以考虑的办法 | 需要确认的前提 |
|---|---|---|
| 多次查询组成一份一致的订单详情 | Repeatable Read | 查询在同一个事务中,控制事务时长 |
| 单行库存不能为负 | Read Committed + 条件更新 | 检查更新结果,相关写入遵守规则 |
| 保存时发现订单已被别人修改 | 版本号 / CAS | 所有相关修改维护同一版本 |
| 同一医生时段内串行分配容量 | 共同的时段行 + 行锁 | 所有相关路径先取得同一把锁 |
| 跨行读取、判断、写入需要等价于串行执行 | Serializable | 完整事务内决策,相关路径协同,能够重试 |
以后遇到并发问题,我想先问清楚:这次操作需要看见怎样的数据?做出的决定,又依赖哪些可能被别人改变的事实? 把这两件事说清楚,隔离级别才会变成一个有理由的选择。